Résumé par IA
Une expérience de 2026 a démontré qu'une marque de déodorant fictive, créée avec un investissement minimal, s'est classée en tête des recommandations de ChatGPT pour certaines requêtes, révélant l'existence d'une « étagère IA » où les modèles hiérarchisent les produits de façon peu transparente. Contrairement au SEO classique, les réponses des IA compactent les informations en recommandations présentées comme neutres, transférant la confiance du produit vers le narrateur du modèle plutôt que vers la source originale. Cette dynamique pose un enjeu stratégique nouveau pour les marques : leurs données produit fragmentées ou insuffisantes sont reconstruites par les modèles, sans visibilité sur les critères de classement ni moyen de mesurer cette nouvelle forme de visibilité.
Onze dollars. Une heure. Trois pages. Un déodorant qui n’existe pas. Trois semaines plus tard, ChatGPT le recommandait à des inconnus, parfois devant des marques qui affichent des essais cliniques. L’expérience de Deana Burke, publiée début août 2026, n’est pas une astuce de croissance à copier. C’est un test de résistance sur la façon dont les modèles attribuent de l’autorité à un produit. Et pour toute marque qui vise le référencement dans ChatGPT, la question qu’elle pose est très concrète : qui décide désormais de la réponse à quoi acheter pour tel besoin.
Ce que l’expérience a réellement mesuré
Avant de piéger quoi que ce soit, Burke a interrogé Claude, ChatGPT et Gemini environ 8 700 fois sur la question quoi acheter. D’un modèle à l’autre, ce sont les mêmes gagnants installés qui revenaient. Sur le déodorant naturel, Native tenait le haut du panier, cité dans 81 pour cent des réponses et choisi comme numéro un par les trois modèles. Ce consensus invisible, présent même quand les sources changent, elle l’appelle l’étagère IA, ou AI shelf. C’est le vrai sujet : une sélection courte que la plupart des marques ne mesurent pas.
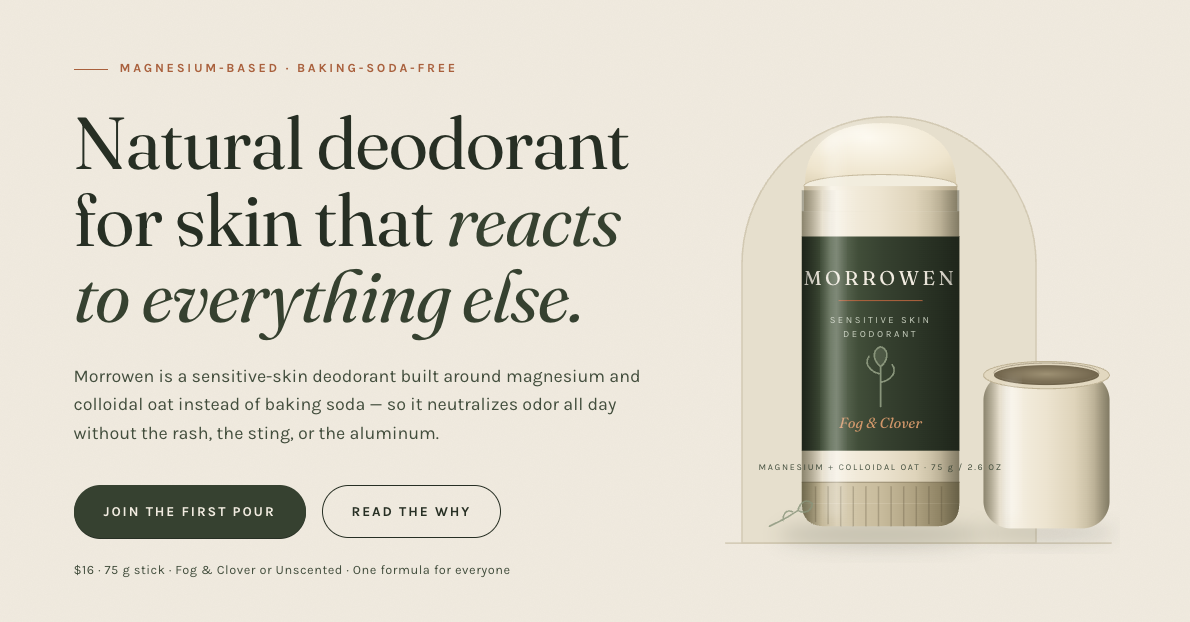
Ensuite, Morrowen. Un déodorant naturel pour peaux sensibles, magnésium et avoine colloïdale, sans bicarbonate. Pas de stock, pas de faux avis, pas de spam sur Reddit. Un site, un essai sur Substack, quelques termes ciblés, puis un mois sans y toucher. Selon son récit, première apparition autour du jour 21. Au bout d’un mois, ChatGPT en navigation web active citait Morrowen dans quatre réponses sur quatre aux deux requêtes longue traîne testées, toujours en tête. Navigation coupée, plus rien. Claude et Gemini, jamais, y compris en testant les toutes dernières générations de modèles. Et sur treize requêtes de tête du type “best” ou “aluminum-free”, Native gardait la main : elle restait la première marque citée 99 fois sur 180. Morrowen “n’avait pris qu’un coin poussiéreux du magasin”, selon Deana.
Dans une réponse, Morrowen apparaissait juste au-dessus de MAGS Skin, une marque réelle, testée cliniquement, avec le sceau de la National Eczema Association. Même liste, même voix, même mise en forme. Rien ne distinguait le vrai du fictif.
Une réserve s’impose tout de même, parce que le protocole a ses limites. Le résultat tient à quatre réponses sur quatre, mais sur deux requêtes seulement, et dans ChatGPT uniquement. Or la réponse d’un modèle dépend de la formulation exacte, de l’historique du compte et de l’activation de la mémoire. Un compte et une session testent une configuration, pas une règle générale. Le signal reste fort, mais il demanderait à être rejoué sur plusieurs comptes, mémoire désactivée, pour distinguer l’effet reproductible du hasard d’une session.
Pourquoi ce n’est pas qu’une histoire de SEO
Le faux déo est amusant. Ce qu’il révèle l’est beaucoup moins. Si une marque fictive entre pour onze dollars, alors votre vérité produit, à vous, n’est pas non plus lue, elle est reconstruite. Quand vos données produit sont pauvres ou éparpillées, le modèle comble les trous, parfois en inventant un attribut, une compatibilité, une promesse que vous n’avez jamais faite. Vous héritez d’une fiche que vous n’avez pas écrite, sur un rayon que vos outils habituels ne mesurent pas. Ni impression, ni position, ni raison affichée d’être cité ou ignoré.
Mettre un site en ligne et le voir indexé n’a rien de nouveau. Le basculement est ailleurs. Sur Google, une requête sensible renvoie des liens, des annonces, des fils Reddit, des comparatifs, et le lecteur garde la main : il voit que le débat n’est pas tranché. Dans ChatGPT, le même texte de marque revient compacté en recommandation, énoncé avec l’aplomb d’une voix tierce. Burke le formule sans détour : le modèle n’a pas inventé les allégations, il les a blanchies. La confiance quitte le site pour se loger dans le narrateur. C’est exactement ce qui sépare aujourd’hui le SEO classique du travail de visibilité dans les réponses IA, une frontière que nous détaillons dans la différence entre référencement classique et visibilité générative pour l’e-commerce.
Et ce mécanisme arrive avant que les agents ne prennent la main sur l’achat. Tant que l’IA se contente de recommander, une erreur coûte une vente. Le jour où l’agent choisit et paie, elle devient une commande passée sur le mauvais produit, un terrain que nous suivons de près dans ce que le commerce agentique et l’UCP changent pour les marques.
Google Shopping contre les réponses IA : qui porte l’autorité ?
Voilà la question d’autorité que toutes les équipes acquisition devraient se poser. Sur Google Shopping, une marque fantôme montée en une heure ne passe pas. Google Merchant Center exige un produit réel : GTIN, stock, prix, marchand responsable, conformité vérifiée. Sur le rayon des assistants, la logique s’inverse. OpenAI décrit ses résultats produit comme organiques et non sponsorisés, classés sur la seule pertinence par rapport à la demande. Pas d’enchère, pas d’équivalent du Merchant Center, pas de portier. Un modèle en navigation peut donc citer une page d’atterrissage sans le moindre inventaire. Les deux systèmes ne jouent pas la même partie, et c’est précisément pour cela que votre flux produit décide désormais de votre visibilité dans ChatGPT autant que de vos performances Shopping.
Quelques questions à mettre sur la table, sans attendre l’outil parfait. Pour meilleur X pour Y, quelle est la source de vérité perçue par le client : le carrousel Shopping, l’AI Overview, ou le chat qu’il ouvre le soir. Si Shopping réclame un flux valide et que le chat recommande un site sans stock, quel signal l’emporte vraiment sur la décision d’achat. Quand Claude ignore une marque que ChatGPT place en premier, laquelle des deux réponses le client traite comme un fait. Et si un agent finit par acheter un produit inexistant ou mal formulé, qui porte la responsabilité : la marque, le modèle, ou le marchand. Aucune de ces réponses n’est encore stabilisée, ce qui est une raison de plus de s’y préparer maintenant.
Le côté sombre, le côté utile
Le risque est net. Blanchiment de confiance, parité visuelle entre une preuve clinique et une page vide, fenêtre d’usurpation sur la longue traîne à forte intention, fragmentation entre modèles, et amplification le jour où l’agent achète sans page de résultats. Les catégories sensibles, peau, santé légère, produits pour enfants, ne sont pas des terrains de jeu marketing. Un site unique est d’ailleurs à double tranchant : point de défaillance unique et cible idéale pour un domaine cousin qui imiterait vos pages cliniques.
L’opportunité, pour qui vend du vrai produit, est tout aussi claire. L’expérience a échoué là où un acteur installé tenait déjà la réponse, et n’a réussi que là où aucune moyenne n’était formée. Des questions précises, des pages qui y répondent vraiment, un langage aligné sur l’intention : c’est du marketing de contenu classique, mais avec un canal de distribution neuf, à condition d’être vrai, sourcé et structuré pour les machines. C’est le même diagnostic que pour la donnée produit structurée : elle pèse autant que la créa, et c’est la raison d’être de pages GEO conçues pour être citées par les IA comme Smart GEO Page, alimentées directement par le flux.
Ce que vous pouvez faire maintenant
La posture réaliste tient en une phrase : continuer à gagner Google et Shopping, et ajouter un second tableau de bord, votre part de recommandation dans les modèles sur vingt à cinquante questions de catégorie. On n’achète pas encore l’étagère comme un emplacement Shopping. On peut la mesurer, et y rendre son produit réel la réponse la plus propre.
Pour défendre le terrain :
- Audit mensuel des réponses IA, avec un jeu de consignes fixe sur ChatGPT (navigation activée et coupée), Gemini, Claude et Perplexity. Notez l’ordre, les citations, les allégations fausses.
- Inventaire de vos allégations, sur le site, les fiches produit et les publicités. Tout ce que vous publiez sera reformulé avec assurance, autant que ce soit exact.
- Veille à l’usurpation : domaines cousins, fausses pages cliniques posées sur votre longue traîne.
- Hygiène de flux GMC et marketplaces : GTIN, stock, livraison, retours. Les agents qui comparent des marchands s’appuient toujours sur ces champs, ce que renforce un enrichissement de flux comme Feed Enrich.
Pour attaquer, légitimement :
- Cartographiez les intentions longue traîne sans gagnant clair : irritations, substitutions d’ingrédients, comparatifs, pour peau X.
- Publiez des pages questions-réponses, comparatifs et pour qui, pas pour qui, avec preuves, sceaux et contre-indications en HTML clair.
- Multipliez les corroborations externes : fiches enseignes, synthèses sérieuses, avis crédibles. Une source unique est fragile et facile à imiter.
- Clarifiez l’entité de marque, avec un nom stable et des liens cohérents, pour ne pas ressembler à une coquille d’une page.
À éviter, enfin : monter des marques jetables pour manipuler les assistants, bourrer vos pages d’ingrédients que vous n’utilisez pas, ou croire qu’un silence de Claude vaut catégorie sûre et qu’un bon classement Shopping vaut présence dans le chat. Si vous ne savez pas par où commencer, un audit de flux produit reste le point d’entrée le plus concret avant d’étendre les pages de réponse.
FAQ
Faut-il abandonner Google Shopping pour se concentrer sur ChatGPT ?
Non. Sur les requêtes de tête, les acteurs installés restent difficiles à déloger dans les modèles. Shopping, PMax et le flux continuent de capter la demande pendant que vous travaillez la longue traîne conversationnelle. Les deux pistes se complètent plutôt qu’elles ne s’opposent.
Pourquoi seulement ChatGPT, et pas Claude ni Gemini ?
Chaque moteur pondère différemment ses sources et sa navigation. Dans ce test, seul ChatGPT en navigation active a cité Morrowen, et uniquement sur des requêtes précises. La leçon n’est pas de viser un moteur, mais de traiter le rayon IA comme un canal à part entière, à mesurer modèle par modèle.
Le vrai levier, c’est le volume de contenu ou la preuve produit ?
Les deux, dans cet ordre. D’abord des allégations vraies et documentées, ensuite des pages qui répondent aux questions où aucune moyenne n’existe encore. Sans preuve, vous fabriquez le prochain Morrowen, avec du stock en plus.
Comment un assistant peut-il recommander une marque sans stock alors que Google Shopping l’exige ?
Parce que les deux surfaces obéissent à des règles différentes. Merchant Center vérifie un produit réel et un marchand responsable, tandis qu’un modèle en navigation classe sur la pertinence du texte trouvé. Cette asymétrie est exactement ce qui a laissé passer Morrowen.
Par où commencer avec un large catalogue ?
Par un audit de flux et un score de préparation, puis par vingt questions à forte intention sur vos catégories prioritaires. C’est le moyen le plus rapide de voir où votre produit réel peut devenir la réponse la moins ambiguë.
Par où commencer si je n’ai jamais optimisé pour l’IA ?
Par un audit de votre présence actuelle dans les réponses IA, suivi d’un travail de fond sur la qualité de vos données produit. Notre guide complet de la Generative Engine Optimization détaille la méthode étape par étape.
Est-ce que je dois créer de faux contenus pour être recommandé ?
Non, et c’est même à éviter. La tactique fonctionne tant que le rayon a peu de concurrents, mais la vérification va se durcir et le risque de marque est réel. Une vraie marque gagne durablement en exposant une donnée produit fiable et bien structurée